Le passage du service hébergé à une installation locale#
Qu’est-ce qui change lorsque Hy4 Flash passe d’un service hébergé à un fichier quantifié sur votre propre matériel ? Un développeur a posé cette question à l’équipe Hy de Tencent sur r/LocalLLaMA après avoir rencontré des erreurs sur une tâche de travail familière. La réponse a renvoyé au choix de la méthode de quantification et de la calibration. Elle a aussi ouvert une question plus pratique pour quiconque dimensionne un matériel local : quelles options appartiennent à Flash, lesquelles sont documentées pour le Hy4 phare, et combien de marge les fichiers laissent-ils pour l’inférence ? La session de questions-réponses a commencé à minuit à Shanghai le 21 novembre, à 8 h du matin heure du Pacifique le 20 novembre, après l’ouverture des poids du Hy4 phare plus tôt dans la journée. Session de questions-réponses Reddit
Le développeur a indiqué que la version hébergée accomplissait la tâche sans erreur et qu’un build NVFP4 local manquait environ 8 % des cas. Le message identifiait une configuration GPU mixte et 96 Go de mémoire système, mais ne fournissait aucun ensemble de tâches public, ni nombre de répétitions, ni précision du backend hébergé. Tencent, par la voix de GeoMorax, a orienté le lecteur vers le build NVFP4 calibré GPTQ de l’équipe et a déclaré que Tencent avait mesuré un écart faible par rapport à BF16 dans sa propre évaluation. Les deux récits décrivent des évaluations distinctes. Leurs bases de référence différentes comptent avant que l’un ou l’autre résultat n’éclète un achat de matériel. Rapport du développeur et réponse de Tencent
Le sujet principal de l’AMA est la question de benchmark du lecteur autour du Flash quantifié. Un utilisateur local a signalé qu’une exécution Flash NVFP4 échouait sur une tâche sur laquelle il compte habituellement. La réponse de l’équipe a désigné la méthode de quantification et la calibration comme des facteurs susceptibles de modifier les résultats. C’est une affirmation plus étroite et plus utile qu’un verdict général sur Flash. Cela signifie que la première question n’est pas de savoir si Flash est bon ou mauvais dans l’abstrait. La première question est de savoir exactement ce qui a été comparé : la même révision de modèle, le même format de poids, le même fichier, le même runtime et les mêmes noyaux, la même longueur de prompt et la même règle de scoring. Sans cet appariement, un échec peut être un problème de format, un problème de calibration, un problème de runtime, un problème de sensibilité à la tâche, ou une combinaison. Il ne peut pas à lui seul être élevé en conclusion au niveau du modèle.
Fil AMA Reddit sur r/LocalLLaMA · Réponse sur Flash NVFP4 et la calibration
Flash quantifié : appariez le contexte de test avant de juger le résultat#
La quantification n’est pas une propriété unique qui demeurerait inchangée d’un fichier à l’autre. C’est une famille de choix concernant la précision numérique, la représentation des poids, les données de calibration, la mise à l’échelle, les noyaux et l’intégration au runtime. Une fiche de modèle peut nommer un format, et un dépôt peut publier un fichier, mais le comportement de ce fichier dépend encore de la pile d’inférence qui le charge et de la charge de travail qui l’exerce. Des connaissances générales sont utiles ici : les formats à précision réduite échangent la plage ou la résolution numérique contre de la mémoire et de la vitesse, et la calibration aide à décider comment mapper les plages réelles de poids ou d’activations dans la représentation disponible. Des données de calibration différentes ou des implémentations de noyaux différentes peuvent donc produire des sorties différentes, en particulier sur des tâches sensibles aux petits changements numériques. La réponse de l’AMA est cohérente avec ce tableau général ; elle n’établit pas un classement universel des formats.
La distinction critique oppose le rapport local d’un utilisateur à une comparaison de référence d’une équipe. Le résultat NVFP4 de l’utilisateur appartient à un seul contexte de test : une machine, un runtime, un fichier, une tâche et une méthode de scoring. Une comparaison BF16 d’équipe appartient à un autre contexte : une précision différente, probablement un chemin de runtime différent, et éventuellement une configuration d’évaluation différente. Ces deux contextes peuvent être tous deux honnêtes sans être directement comparables pour autant. L’un ne réfute pas l’autre. Un résultat BF16 peut montrer ce que fait le modèle sous une précision de référence sans prouver qu’un fichier NVFP4 particulier préservera ce comportement sur la charge de travail d’un utilisateur. Un échec d’utilisateur peut montrer qu’une configuration locale spécifique n’est pas acceptable pour cette charge de travail sans prouver que tous les builds Flash échouent. La lecture correcte est conditionnelle : ce fichier, ce runtime, cette tâche, ce résultat.
Exemple 1 — une tâche Flash NVFP4 échouée n’est pas un verdict sur Flash. Supposons qu’un développeur exécute un fichier Flash NVFP4 dans un runtime local et constate qu’une tâche d’extraction structurée perd l’ordre des champs ou omet une clé requise. Le développeur dispose aussi d’un résultat BF16 issu d’un environnement différent qui préserve les champs. L’étape suivante utile n’est pas de déclarer Flash inadapté. Elle consiste à maintenir la révision de modèle constante et à faire varier un facteur à la fois : BF16 contre NVFP4 dans le même runtime ; deux fichiers NVFP4 avec une calibration ou un conditionnement différent ; le même fichier avec un chemin de noyau différent ; et le même fichier avec un prompt plus court ou un lot plus petit. Si l’échec suit le fichier à travers les runtimes, le fichier ou sa calibration est le principal suspect. Si l’échec suit le runtime, le noyau ou l’intégration est le principal suspect. Si l’échec n’apparaît qu’à contexte long ou à lot élevé, la forme de la charge de travail fait partie de l’explication. Il s’agit d’un flux de travail illustratif, non d’un résultat de test rapporté.
Une question de benchmark doit donc être rédigée comme un contrat de comparaison. Elle doit nommer l’identifiant exact du modèle et sa révision, le format de poids, la révision du fichier ou du dépôt, le runtime et la construction des noyaux, la recette de quantification si elle est publiée, le prompt ou l’ensemble d’évaluation, la longueur de contexte, la taille du lot, les paramètres d’échantillonnage et la méthode de scoring. Elle doit aussi indiquer si la comparaison est en ligne ou locale, car un point de terminaison en ligne et un fichier local sont des contextes de service différents même lorsque la famille de modèles est la même. Si l’un de ces champs manque, le résultat reste une preuve, mais une preuve plus faible. Il peut justifier une prudence locale. Il ne peut pas justifier une affirmation large sur la famille de modèles.
La fiche de modèle de Tencent indique 12 milliards de paramètres actifs par token pour Hy4 Flash et un composant Engram de 64 milliards de paramètres. Le nombre actif décrit le chemin de calcul pour un token. La planification de la capacité doit aussi tenir compte des poids stockés, des tampons de runtime, de la taille du lot, de la longueur de contexte et de la quantification choisie. La distinction compte même lorsque deux builds partagent un même nombre de paramètres actifs et exposent la même interface de discussion. Ils peuvent occuper des quantités de mémoire différentes, envoyer des travaux différents au GPU et se comporter différemment sur la tâche qu’une équipe a réellement besoin d’exécuter.
Fiche de modèle Hy4-flash · Dépôt GGUF Flash
Les versions Flash et le modèle phare Hy4#
L’AMA devient plus lisible une fois que Flash et le Hy4 phare sont maintenus sur des voies distinctes. Flash est la branche plus petite et plus rapide, où les builds quantifiés et les formats de fichiers destinés à la communauté sont au centre de l’expérimentation locale. Le Hy4 phare est un modèle beaucoup plus grand, avec son propre récit de déploiement publié. La fiche de modèle Hy4 indique une ossature linguistique de 770 B et 49 B de paramètres activés par token. Elle documente aussi le support officiel FP8 et renvoie vers des artefacts GGUF compressés. Ce sont des faits concrets et vérifiables sur la surface de support publiée du phare. Ce ne sont pas la preuve que chaque format de quantification est activé, ni la preuve qu’une machine locale donnée peut contenir le modèle.
La réponse de l’équipe sur les formats du phare trace une ligne qui compte pour quiconque assemble une pile locale. La réponse indique que des formats tels que NVFP4 ne sont pas activés pour le phare, et le lien communautaire cité dans ce contexte est un exemple Flash. Cette distinction est facile à estomper parce que le nom de famille de modèles est partagé et parce que les deux branches apparaissent dans le même fil AMA. Un fichier Flash NVFP4 et un fichier phare NVFP4 ne sont pas des décisions de déploiement interchangeables. Un build Flash quantifié peut faire partie active de l’écosystème local. Un build phare NVFP4 n’est pas établi par cette discussion. Le chemin FP8 documenté du phare et les artefacts GGUF compressés liés constituent les points de départ pertinents ; une affirmation de format non pris en charge ne doit pas être déduite de l’activité Flash.
Exemple 2 — un fichier phare NVFP4 et un fichier Flash NVFP4 sont des décisions différentes. Imaginez un opérateur doté d’un budget GPU fixe qui voit un message communautaire sur NVFP4 et suppose que la même voie s’applique à Hy4. L’opérateur doit d’abord demander à quelle branche de modèle le message se rapporte. S’il concerne Flash, il dit quelque chose sur une branche plus petite et son écosystème quantifié. Il n’établit pas que le phare dispose d’un chemin NVFP4 activé. Pour le phare, l’opérateur doit partir du support FP8 documenté et des artefacts GGUF compressés liés, puis vérifier la combinaison exacte du fichier et du runtime. Si l’opérateur a besoin de NVFP4 spécifiquement, la conclusion correcte à tirer de l’AMA est que le NVFP4 phare n’est pas confirmé dans cette réponse, et non qu’un fichier phare NVFP4 a été validé ailleurs. Il s’agit d’un exemple d’arbre de décision, non d’une affirmation de performance.
La planification de la mémoire est elle aussi propre à chaque branche. Le fait qu’un modèle puisse être décrit comme 49 B actifs par token ne signifie pas qu’il n’a besoin que de la mémoire associée à 49 B de paramètres. Les paramètres actifs décrivent le chemin de calcul ; la mémoire des poids résidents dépend du total des poids stockés et du format. En plus des poids, un déploiement local a besoin de place pour les tampons de runtime, l’attention ou le cache KV, le traitement par lots et le contexte. Le même modèle à un contexte plus long peut nécessiter nettement plus de mémoire qu’une démo à prompt court. C’est pourquoi l’étiquette de paramètres d’un modèle, la taille d’un fichier quantifié et la RAM d’une machine sont trois nombres distincts. Une décision de déploiement a besoin des trois, plus une exécution mesurée.
Fiche de modèle Hy4 · Réponse sur les formats du phare
La question 64–128 Go : un propos de feuille de route, pas une spécification mémoire#
La discussion 64–128 Go est la partie de l’AMA la plus susceptible d’être surinterprétée. Deux réponses différentes pointent vers des modèles plus petits encore en planification. Une réponse mentionne un Hy4-mini au programme. Une autre aborde une question sur la plage de RAM 64–128 Go. Ce sont des signaux liés, mais pas une annonce de produit. La plage est une question de la communauté sur une enveloppe mémoire ; ce n’est pas une configuration prise en charge publiée. La mention de la feuille de route est une déclaration d’intention ou de direction ; ce n’est pas une date de lancement, une liste de fichiers ni une cible de déploiement validée. La distinction n’est pas pédante. Les opérateurs locaux budgétisent leur matériel par rapport à des configurations prises en charge, et une conversation de feuille de route peut facilement devenir une spécification d’approvisionnement accidentelle si elle est répétée sans son étiquette de statut.
Aucun engagement de lancement n’apparaît dans le matériel utilisé ici. Cette absence est en elle-même un constat. Elle signifie qu’un lecteur ne doit pas déduire de l’échange sur 64–128 Go une fenêtre de sortie, une taille de modèle, un plan de quantification ou une exigence mémoire minimale. L’équipe a aussi évoqué le post-entraînement et le travail sur des modèles plus grands dans la même AMA. Ces sujets montrent qu’optimiser les modèles existants, réduire l’échelle de déploiement et construire des modèles plus grands sont des flux de travail distincts. Un point de feuille de route sur un modèle plus petit n’implique pas que le phare est remplacé. Une discussion sur le post-entraînement n’implique pas un nouveau point de contrôle. Une question sur une plage mémoire n’implique pas qu’un modèle a été adapté à cette plage. Chaque affirmation doit rester dans sa propre voie.
Exemple 3 — transformer une question 64–128 Go en plan de test, pas en affirmation de support. Supposons qu’une équipe dispose d’une machine de 96 Go et veuille savoir si l’AMA lui donne le feu vert. Ce n’est pas le cas. La réponse utile consiste à définir une matrice de test : quelle branche de modèle, quel format documenté, quel fichier exact, quel runtime, quelles longueurs de contexte et quelles tailles de lot. L’équipe doit mesurer la mémoire résidente maximale et la qualité des sorties pour chaque combinaison, plutôt que de traiter le point médian d’une plage communautaire comme une cible. Si un build Flash tient à contexte court mais échoue à la longueur de contexte requise par l’équipe, la machine n’est pas validée pour cette charge de travail. Si un artefact compressé phare ne tient qu’avec un runtime particulier et un petit lot, c’est une configuration mesurée, pas une approbation générale 64–128 Go. La plage peut aider à formuler une question. Elle ne peut pas répondre à elle seule à la question de l’adéquation.
La même prudence s’applique à l’expression « modèle plus petit ». Un modèle plus petit peut signifier moins de paramètres au total, un chemin de paramètres actifs différent, un schéma de quantification différent ou une cible de déploiement différente. Le matériel de l’AMA ne résout pas ces possibilités en une spécification. Un lecteur peut raisonnablement conclure que Tencent Hy discute de travaux continus sur des modèles plus petits. Un lecteur ne peut pas raisonnablement conclure qu’il existe un modèle nommé, avec une taille connue, un plancher mémoire et une date de sortie. Le statut de feuille de route doit être consigné comme tel jusqu’à ce qu’une fiche de modèle, un dépôt ou une note de version fournisse les détails manquants.
Réponse sur la feuille de route des modèles plus petits · Réponse à la question 64–128 Go
Cinq fichiers de poids Flash, de 125 à 157 Gio#
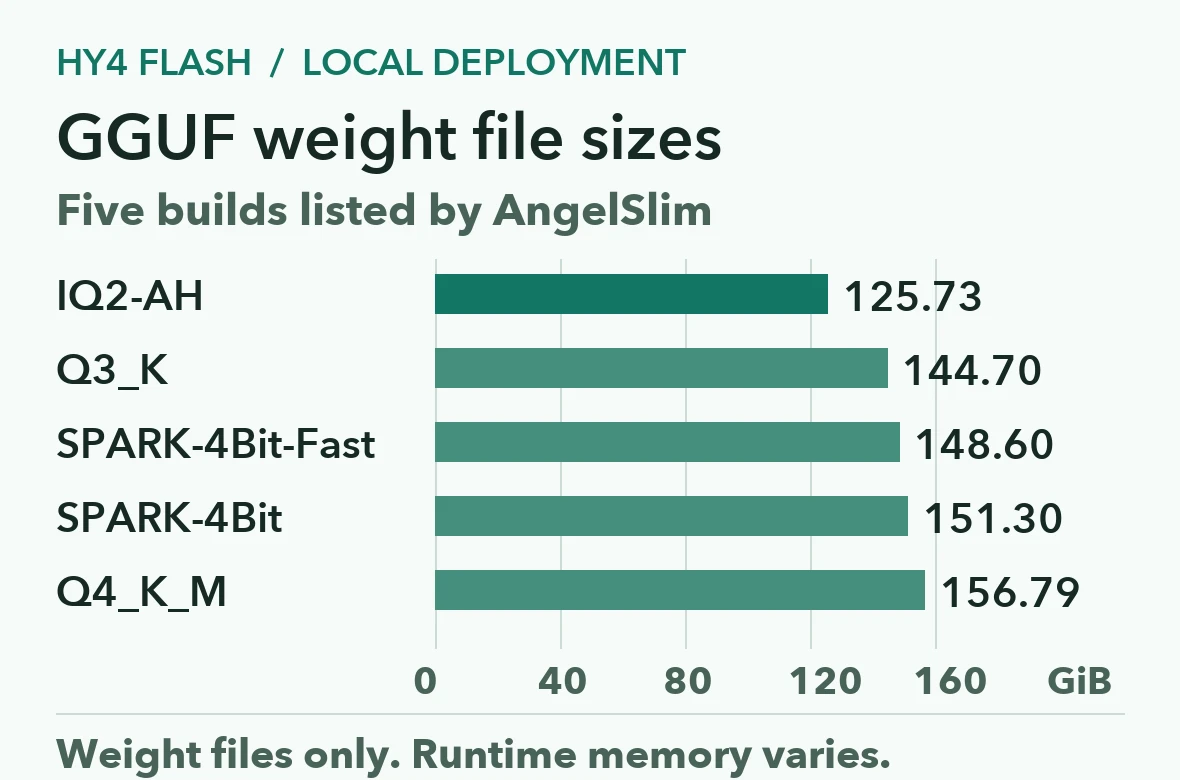
Le dépôt GGUF Flash répertorie cinq ensembles de poids de tailles différentes. L'entrée la plus petite d'AngelSlim, IQ2-AH, fait 125,73 GiB. Q3_K fait 144,70 GiB, SPARK-4Bit-Fast fait 148,60 GiB, SPARK-4Bit fait 151,30 GiB et Q4_K_M fait 156,79 GiB. Les deux extrémités de la plage diffèrent de 31,06 GiB. C'est une différence significative pour le stockage, la distribution et la marge restante pour tout le reste sur une machine. Les fichiers appartiennent à la branche Flash et les chiffres du graphique sont les tailles de poids déclarées par le dépôt. La fiche modèle Flash GGUF d'AngelSlim
Les unités comptent à l'extrémité basse. Le fichier de 125,73 GiB occupe environ 135 Go lorsqu'il est mesuré en gigaoctets décimaux, de sorte qu'une machine annoncée avec exactement 128 Go de mémoire adressable et aucun autre pool mémoire serait déjà sous le total des seuls poids si tous les poids devaient être résidents ensemble. Même une machine de 128 GiB n'aurait qu'environ 2,27 GiB restants après le fichier, avant le processus, le système d'exploitation, le cache d'attention et les tampons de travail. Ce sont des comparaisons arithmétiques, pas des mesures de l'utilisation de la mémoire. Le déchargement vers le périphérique et le stockage mappé en mémoire peuvent changer l'emplacement des octets et la rapidité de leur lecture. C'est pourquoi une différence apparemment faible entre Go et GiB peut changer l'interprétation d'un seuil sans trancher la question des performances.
Le dépôt liste séparément un fichier de projection visuelle. Une équipe évaluant les entrées d'images a un autre artefact à prendre en compte, ainsi que la méthode du runtime pour préparer les médias. La comparaison de stockage laisse également de côté le temps de chargement du modèle, les jetons par seconde et la qualité de la sortie. Ces questions deviennent plus importantes lorsque la charge de travail choisie alterne texte et images ou maintient de longues sessions ouvertes. Un téléchargement plus court est un avantage opérationnel immédiat pour la distribution. La question de savoir si sa précision numérique est suffisante dépend de l'application et du runtime. Fichiers Flash et documentation du modèle
Contexte AMA et relevé chronologique · Réponse à la discussion post-entraînement
Limites de la source et ce qui changerait la conclusion#
L'ensemble de sources a des limites claires. Il contient un fil AMA public, des réponses individuelles, des fiches modèles et un dépôt GGUF. Il ne contient pas de reproduction indépendante du rapport Flash NVFP4. Il ne contient pas de benchmark contrôlé émanant d'une partie neutre. Il ne contient pas de tableau de configurations prises en charge publié pour la plage 64–128 Go. Il ne contient pas de note de version pour un modèle plus petit. Ces absences comptent, car les conclusions de l'article sont en conséquence limitées. L'AMA soutient une clarification des catégories de déploiement. Il ne soutient pas un classement de performances, une garantie mémoire ou une prévision de lancement.
La fiche modèle de Tencent donne à Flash une fenêtre de contexte allant jusqu'à un million de jetons. Une longueur de contexte maximale décrit une capacité du modèle annoncée. Il donne aux opérateurs une raison de tester leur déploiement aux tailles de prompt dont ils ont besoin, puisque la mémoire et la latence peuvent changer brutalement à mesure que les prompts s'allongent. Des conversations courtes, un long corpus de texte et une file de requêtes simultanées sont des charges de travail distinctes, même sur le même point de contrôle. Pour les outils hébergés localement, documenter le contexte de travail le plus long à la concurrence cible est plus pratique que d'enregistrer le seul plafond architectural. Fiche modèle Hy4 Flash
La limitation la plus importante est la séparation des contextes de test. Le résultat d'un utilisateur et le rapport d'une équipe ne sont pas deux votes dans un sondage. Ce sont des expériences différentes avec des contrôles différents. L'exécution NVFP4 de l'utilisateur peut être très pertinente pour la pile de cet utilisateur, et la comparaison BF16 de l'équipe peut être très pertinente pour un déploiement de référence, mais ni l'une ni l'autre ne remplace automatiquement l'autre. Une conclusion plus solide nécessiterait une comparaison appariée : même révision du modèle, même ensemble d'évaluation, même famille de runtime, et seul le format des poids varié. Sans cela, l'affirmation honnête est que la méthode de quantification et la calibration peuvent affecter les résultats, et que la validation locale reste nécessaire.
Qu'est-ce qui changerait la conclusion ? Une fiche modèle publiée qui nommerait les formats de quantification pris en charge pour le modèle phare préciserait la frontière du support. Un benchmark contrôlé qui ne ferait varier que le format des poids clarifierait la question Flash NVFP4. Un dépôt ou une note de version mentionnant un modèle plus petit nommé, un plancher de mémoire et une date de lancement ferait passer la discussion sur la feuille de route dans une configuration confirmée. Un profil de mémoire mesuré à des longueurs de contexte définies remplacerait la spéculation sur 64–128 Go par une affirmation d'adaptation testable. D'ici là, les conseils pratiques de l'article restent conditionnels plutôt que prédictifs.
Fiche modèle Hy4-flash · Fiche modèle Hy4 · Dépôt GGUF Flash
Guide pratique de décision pour les opérateurs locaux#
Pour un opérateur local, le résultat le plus utile de l'AMA est une séquence de décision. D'abord, identifier la branche : Flash ou modèle phare. Ensuite, identifier le format documenté pour cette branche. Troisièmement, identifier l'artefact et la révision exacts. Quatrièmement, définir la charge de travail : longueur du prompt, longueur du contexte, taille du lot et scoring. Cinquièmement, mesurer la pile complète plutôt que d'inférer la mémoire à partir d'une étiquette de paramètre. Sixièmement, noter si le résultat provient d'un contexte utilisateur, d'un contexte d'équipe ou d'une comparaison appariée. Cette séquence est plus lente que de lire un chiffre dans un titre, mais elle empêche l'erreur la plus courante en déploiement local : traiter un nom de famille comme s'il s'agissait d'une configuration validée.
Exemple 4 — une note d'approvisionnement qui survit à la relecture. Une équipe veut acheter une machine pour l'inférence locale et rédige une note disant que l'AMA a discuté de 64–128 Go, donc une machine de 96 Go devrait suffire. Un relecteur devrait rejeter cette inférence. Une meilleure note dirait que l'AMA a abordé une question de la communauté sur 64–128 Go et a mentionné des modèles plus petits sur la feuille de route, mais n'a publié aucune configuration prise en charge. L'équipe va donc benchmarker les artefacts Flash et phare documentés pour sa branche, à la longueur de contexte requise, et enregistrera la mémoire de pointe et la qualité. La décision d'achat suivra le résultat mesuré, pas le point médian de la plage. Cet exemple montre comment utiliser l'AMA comme preuve sans transformer une question en exigence.
Pour les utilisateurs de Flash, la réponse sur la calibration plaide pour conserver côte à côte une exécution de référence et une exécution quantifiée. Un résultat BF16 de référence ou au format officiel peut aider à distinguer un comportement du modèle d'un artefact de quantification, mais seulement si le reste du contexte est suffisamment proche. Pour les utilisateurs du modèle phare, la réponse sur le format plaide pour commencer par le chemin FP8 documenté ou les artefacts compressés liés et pour traiter NVFP4 comme non confirmé jusqu'à ce qu'une source propre à la branche dise le contraire. Pour les équipes qui suivent la feuille de route, la discussion sur les modèles plus petits est un signal pour surveiller les fiches modèles et les dépôts, pas une raison de figer un plan matériel autour d'un futur modèle sans nom.
La leçon plus large est que les décisions d'inférence locale sont des problèmes de preuve. Une famille de modèles peut avoir une communauté active, un riche ensemble de fichiers quantifiés et une AMA détaillée, et néanmoins nécessiter un test local avant une affirmation de déploiement. L'AMA Tencent Hy est précieux car il explicite plusieurs de ces limites : la quantification Flash nécessite une comparaison appariée, les formats du modèle phare ne sont pas interchangeables avec les formats Flash, et la plage 64–128 Go est une question plutôt qu'une spécification. Ce sont des conclusions modestes, mais durables. Elles disent au lecteur ce qu'il faut vérifier ensuite, ce qui est plus utile qu'un verdict prématuré.